Cerebras stock nearly doubles on day one as AI chipmaker hits $100 billion — what it means for AI infrastructure
Cerebras가 나스닥 상장 첫날 공모가 185달러 대비 거의 두 배 수준인 350달러까지 치솟으며 시가총액 1,000억 달러를 돌파했습니다. 기사 핵심은 단순 IPO 흥행이 아니라, 4조 트랜지스터·90만 코어의 웨이퍼 스케일 AI 칩이 엔비디아 대안 인프라로 인정받기 시작했다는 점이에요. 한국의 AI 인프라·반도체 업계 입장에선 추론 중심 시장에서 메모리 대역폭과 시스템 아키텍처 경쟁이 더 중요해지고 있다는 신호로 볼 만합니다.
VentureBeat
Databricks tested a stronger model against its multi-step agent on hybrid queries. The stronger model still lost by 21%.
데이터브릭스 연구에 따르면, 구조화 데이터와 비정형 데이터를 함께 다루는 하이브리드 질의에서 멀티스텝 에이전트가 단일 턴 RAG보다 STaRK 벤치마크 기준 20% 이상 높게 나왔고, 더 강한 기반 모델로 바꿔도 여전히 21~38% 뒤졌습니다. 한국 기업의 생성형 AI 프로젝트가 ‘더 큰 모델’보다 ‘질문 분해·SQL+검색 결합·도구 오케스트레이션’ 같은 아키텍처 문제를 먼저 풀어야 한다는 점을 명확히 보여줍니다.
VentureBeat
AI Is Finding Bugs That Hackers Can Exploit. Get Ready for Bugmageddon.
WSJ는 Anthropic의 Mythos 같은 모델이 취약점을 빠르게 찾아내면서, 백악관과 업계가 ‘버그 대란’에 대비하고 있다고 전했습니다. AI가 생산성 도구를 넘어 공격·방어 균형 자체를 흔들고 있다는 얘기로, 한국 기업도 코드 생성보다 취약점 대응 속도와 보안 체계 자동화가 더 중요해질 수 있다는 점을 시사합니다.
WSJ Tech
Siri AI
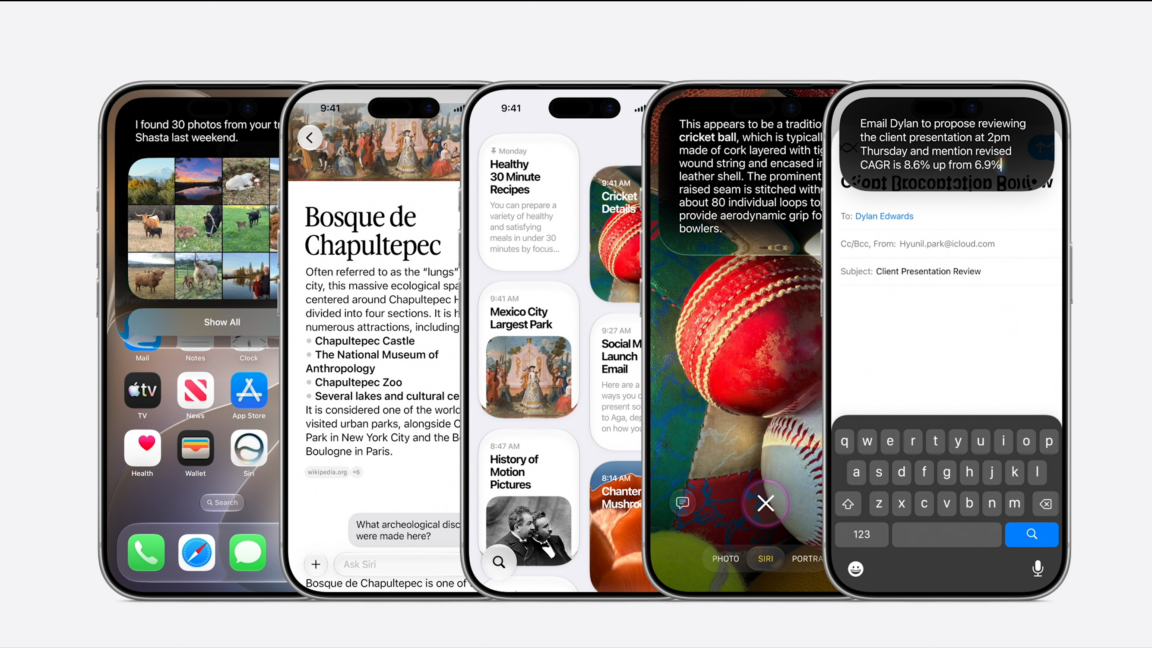
Apple이 올가을 공개 예정인 ‘Siri AI’를 발표하면서 대화형 보조, 개인 맥락 이해, 앱 액션 실행, 비주얼 인텔리전스, 사진 편집, 글쓰기 보조까지 Apple Intelligence 전반을 확장했습니다. 아이폰·아이패드·맥 전반의 기본 UX가 AI 중심으로 재설계되는 흐름이라, 한국 개발자와 프로덕트 팀은 앱 연동 방식과 사용자 기대치 변화를 미리 준비할 필요가 있습니다.
Hacker News Best
Train-to-Test scaling explained: How to optimize your end-to-end AI compute budget for inference
위스콘신대와 스탠퍼드 연구진이 모델 크기, 학습 데이터량, 테스트 시 샘플 수를 함께 최적화하는 'Train-to-Test scaling laws'를 제안했습니다. 핵심은 Chinchilla식 정답보다 더 작은 모델을 더 많은 데이터로 과학습시키고, 아낀 연산 예산을 추론 시 반복 샘플링에 쓰는 편이 복잡한 추론 작업에서 더 효율적일 수 있다는 점으로, 한국의 AI 서비스팀에겐 모델 서빙 비용을 다시 계산해볼 만한 근거가 됩니다.
VentureBeat
"모델 라우팅 넘어 실행 위치까지 자동 배분"… 퍼플렉시티, '하이브리드 추론 오케스트레이터' 공개
퍼플렉시티가 AI 작업을 클라우드와 사용자 PC에 실시간으로 자동 분산하는 ‘하이브리드 추론 오케스트레이터’를 공개했습니다. 데이터센터 전력 부족과 클라우드 비용 상승을 동시에 겨냥한 접근이라, 한국의 AI 서비스 기업이나 온디바이스 전략을 고민하는 제조사·플랫폼사에 꽤 실질적인 시사점을 줍니다.
AITimes
리퀴드 AI, '갤럭시 S25 울트라'에서 작동하는 450M VLM 출시
리퀴드 AI가 갤럭시 S25 울트라급 모바일 기기에서 클라우드 없이 돌아가는 초경량 비전-언어 모델(VLM)을 공개했습니다. 엣지 환경에서 이미지·영상 이해와 실시간 행동 생성까지 가능하다는 점이 핵심이라, 한국의 모바일·로봇·임베디드 AI 개발자들에게 온디바이스 AI 설계 방향을 보여주는 사례로 볼 만합니다.
AITimes
오픈AI, 실시간 음성 작업용 오디오 모델 3종 API에 도입
오픈AI가 실시간 대화 중 추론·번역·전사·작업 수행까지 가능한 음성 모델 3종을 API에 공개했습니다. 음성 인터페이스가 단순 STT를 넘어 ‘업무를 수행하는 에이전트’ 단계로 가고 있다는 신호라서, 한국 개발자와 AI 서비스 기업에도 바로 적용 가능한 변화입니다.
AITimes
메타, ‘토큰화’ 없애고 추론 효율 2배 높인 바이트 언어모델 'BLT' 공개
메타와 공동 연구진이 토큰화 없이 바이트 단위로 동작하는 언어모델 BLT와 추론 효율을 크게 높이는 기법 3종을 공개했습니다. 한국 AI 엔지니어에게는 토크나이저 병목과 다국어 처리 비용을 줄일 수 있는 차세대 LLM 설계 방향이라는 점에서 중요하고, 특히 한국어처럼 토큰 효율 이슈가 있는 언어권에서 더 의미가 큽니다.
AITimes
Mesh LLM - iroh 기반 분산 AI 컴퓨팅
iroh의 Mesh LLM은 여러 대의 머신에 흩어진 GPU와 메모리를 묶어 하나의 OpenAI 호환 API처럼 쓰게 해주는 분산 AI 런타임입니다. 로컬 실행·피어 라우팅·레이어 단위 분할 실행까지 지원해, 한국 기업 입장에선 사내 유휴 GPU를 활용해 비용과 데이터 통제를 동시에 챙길 수 있는 흥미로운 대안입니다.
Hacker News Best
New method aims to keep kids safe from illegal AI-generated content
MIT 연구진이 아동 성착취물(CSAM) 같은 불법 AI 생성물을 직접 만들지 않고도, 모델이 그런 능력으로 특화됐는지 판별하는 감사 기법을 내놨습니다. 2025년 AI 생성 CSAM 신고가 150만 건을 넘긴 상황에서, 모델 내부 표현을 분석해 100% 정확도로 위험 모델 변형을 식별했다는 점이 핵심이고, 한국의 AI 안전성 평가·오픈소스 모델 거버넌스에도 참고할 만합니다.
MIT News AI
Corti의 새 Symphony Speech-to-Text, 의료 용어 정확도에서 OpenAI 앞서… 특화 AI 가치 부각
헬스케어 AI 스타트업 Corti가 의료 음성인식 모델 Symphony를 공개했는데, 영어 의료 용어 기준 WER 1.4%로 OpenAI 17.7%, Whisper 17.4% 등을 크게 앞섰다고 주장했습니다. 의료처럼 오인식 비용이 큰 분야에선 범용 모델보다 산업 특화 모델이 더 유리하다는 사례라서, 한국의 병원·의료AI 업체들에게도 ‘전문화된 데이터와 모델링’의 중요성을 다시 보여줍니다.
VentureBeat
Cerebras "자사 칩, 1조 파라미터 AI 모델을 GPU 클라우드보다 최대 7배 빠르게 구동"
Cerebras가 Moonshot AI의 1조 파라미터급 Kimi K2.6 모델을 초당 981토큰으로 서비스하며, GPU 기반 클라우드보다 최대 6.7배 빠르다고 주장했습니다. AI 서비스 병목이 학습보다 추론 비용과 지연으로 옮겨가는 상황에서, 한국의 AI 인프라·반도체 업계에도 ‘GPU 외 대안 아키텍처’의 실전 가능성을 보여주는 사례입니다.
VentureBeat
더 대화형으로 진화한 ‘Siri AI’ 등장…Apple 새 음성 비서 발표
Apple이 WWDC에서 더 대화형인 ‘Siri AI’를 공개했고, 올가을 OS 업데이트와 함께 출시하겠다고 밝혔습니다. 메시지·메일·사진 같은 개인 데이터 맥락을 바탕으로 여러 앱을 넘나들며 일정 확인, 레시피 생성, 길찾기, 초대 메시지 작성까지 이어서 처리하는 점이 핵심입니다. 한국 개발자와 제품팀에는 Apple 생태계 안에서 ‘개인 맥락 기반 AI UX’가 어떻게 구현되는지 보여주는 신호탄입니다.
Ars Technica
NVIDIA, Windows 기기부터 클라우드·로컬까지 아우르는 에이전틱 AI 통합 스택 위해 Microsoft와 협력
엔비디아와 마이크로소프트가 Build에서 Windows용 RTX Spark·DGX Station, Azure Foundry용 Nemotron/Claude 지원, GitHub Copilot용 OpenShell 런타임까지 묶은 ‘에이전트 AI 풀스택’을 공개했습니다. 한국 개발자와 기업 입장에선 온디바이스 AI PC부터 Azure 기반 엔터프라이즈 배포까지 하나의 경로로 연결된다는 점이 중요하고, 하반기 AI 워크스테이션·로컬 에이전트 도입 흐름에도 직접적인 영향을 줄 수 있습니다.
Nvidia Blog
OpenAI, 사무직 업무용 새 Codex 도구 출시
오픈AI가 Codex에 새로운 업무용 기능을 추가하면서, 이 도구를 단순 코딩 보조를 넘어 문서·리서치·사내 지식 작업 같은 화이트칼라 업무 전반으로 확장하려는 전략을 드러냈습니다. 한국 기업 입장에선 개발팀뿐 아니라 기획·운영·백오피스까지 AI 에이전트 도입 범위를 넓힐 수 있는 신호라서, 업무 자동화 ROI를 다시 계산해볼 만한 뉴스입니다.
TechCrunch
MiMo-v2.5-Pro-UltraSpeed: 초당 1000토큰 처리하는 1T 모델
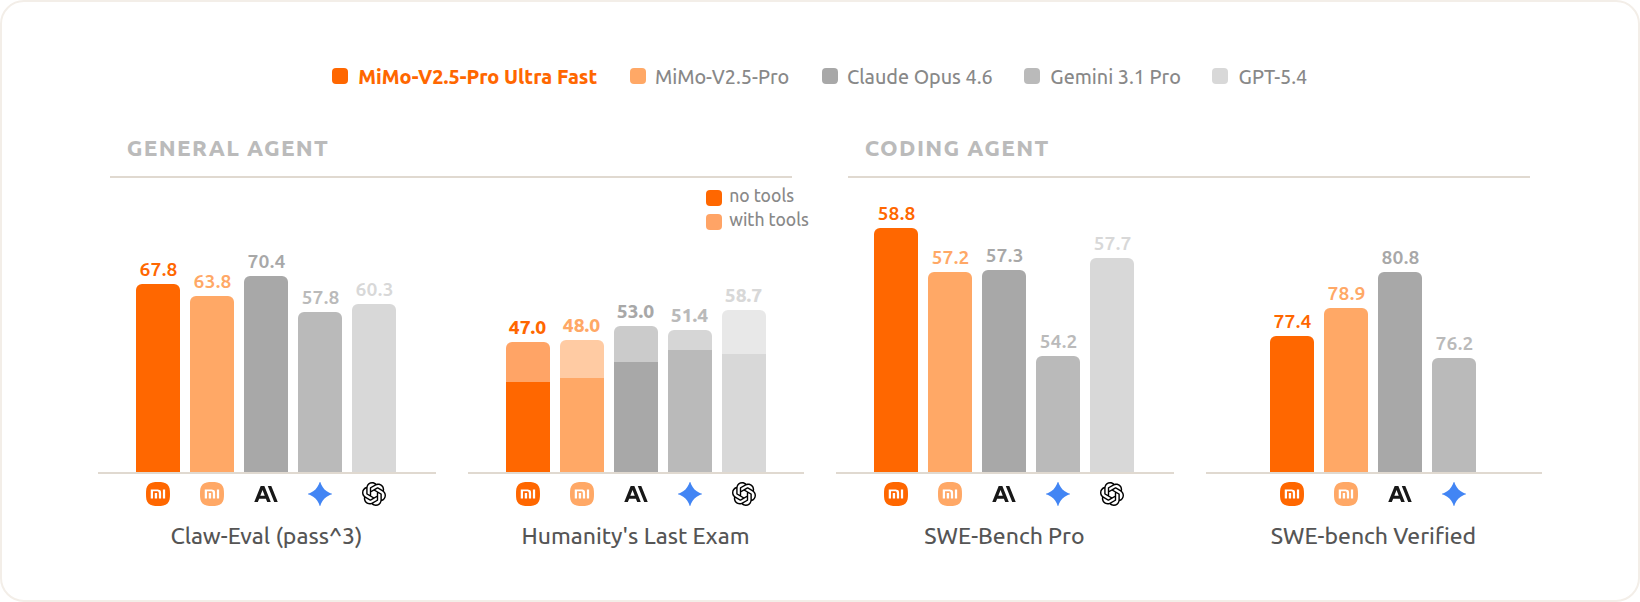
샤오미가 TileRT와 함께 1조(1T) 파라미터급 MiMo-V2.5-Pro-UltraSpeed 모델의 디코드 속도를 1000 tokens/s 이상으로 끌어올렸다고 발표했습니다. 가격은 기존 Pro 대비 3배지만 속도는 약 10배라고 주장하며, 6월 9~23일 동안 승인 기반 API/채팅 체험을 제한적으로 제공합니다. 한국 개발자·AI 인프라 팀 입장에선 모델 성능 자체보다도 ‘초고속 추론이 제품 경험과 테스트-탐색형 워크플로를 어떻게 바꾸는가’를 보여주는 신호라는 점이 중요합니다.
Hacker News Best
Cohere, 단일 H100에서 구동되는 코딩 에이전트 오픈소스로 공개
Cohere가 Apache 2.0 라이선스로 공개한 North Mini Code는 300억 파라미터 MoE 구조지만 토큰당 활성 파라미터는 30억 수준이라 단일 H100에서 구동 가능합니다. 256k 컨텍스트, 터미널 작업·코드 리뷰·아키텍처 매핑 지원, 7만 개 이상의 검증 가능한 태스크 학습 등 agentic software engineering에 맞춰 설계된 것이 특징입니다. 한국 개발 조직에선 폐쇄형 코딩 모델 의존도를 낮추면서도 온프레미스나 비용 제약 환경에서 실험할 수 있는 선택지라는 점이 중요합니다.
VentureBeat
새 연구, 의료 AI AMIE가 건강 상태 관리에 어떻게 도움 되는지 보여줘
구글은 Nature에 발표한 연구에서 의료 AI ‘AMIE’가 일회성 진단을 넘어 장기 질환 관리 대화와 치료 계획 수립까지 지원할 수 있다고 밝혔습니다. 21명의 1차 진료 의사와 비교한 블라인드 평가에서 전반적 관리 추론은 비슷했고, 계획의 정확성과 가이드라인 정합성에서는 더 높은 점수를 받았다는 점이 핵심으로, 국내 디지털 헬스케어 업계에도 임상 워크플로우 재설계 가능성을 시사합니다.
Google AI Blog
"1500달러로 LLM 사전학습"…사피언트, '트랜스포머' 넘는 새 아키텍처 공개
싱가포르 스타트업 사피언트 인텔리전스가 10억 파라미터 규모 모델을 약 1500달러로 사전학습할 수 있다고 주장하며 HRM 기반 ‘HRM-Text’를 공개했다. 트랜스포머 대안 아키텍처가 실제로 비용 대비 성능을 입증한다면, 한국의 스타트업·연구팀에도 모델 개발 진입장벽을 낮출 수 있는 흥미로운 신호다.
AITimes
연구진, LLM 추론 전략 설계 자동화로 토큰 사용량 69.5% 절감
Meta·Google·대학 연구진이 공개한 AutoTTS는 사람이 직접 짜던 test-time scaling 전략을 자동으로 탐색해, 정확도를 유지하면서 토큰 사용량을 최대 69.5% 줄였다고 주장합니다. 한국 기업이 LLM을 프로덕션에 붙일 때 가장 큰 고민인 추론비용과 지연시간을 동시에 건드리는 주제라서, 에이전트·리즈닝 워크로드를 운영하는 팀이라면 체크할 만합니다.
VentureBeat
오픈AI, 스스로 가설 세우고 실험·검증하는 'AI 화학자' 프로젝트 공개
오픈AI가 Molecule.one과 함께 가설 생성, 실험 설계, 결과 검증까지 이어지는 ‘자율 AI 화학자’ 프로젝트를 공개했습니다. 단순 보조 도구를 넘어 실제 과학 연구 워크플로를 자동화하려는 시도라는 점에서, AI가 R&D와 신약 개발 생산성을 얼마나 바꿀지 가늠하게 해주는 사례입니다.
AITimes
에이전틱 테스팅 - E2E 테스트 스택에서 에이전트의 역할
Slack 엔지니어링은 200건이 넘는 에이전틱 워크플로를 돌려, 에이전트 기반 E2E 테스트가 기존 결정론적 테스트를 완전히 대체할 수 있는지 검증했습니다. 결론은 ‘대체’보다는 보완에 가깝다는 점인데, AI 에이전트를 QA 스택에 어떻게 넣을지 고민하는 한국 개발팀엔 꽤 실전적인 참고 자료가 됩니다.
GeekNews
OpenAI limits GPT-5.6 rollout after government request, says restrictions shouldn’t be the norm
OpenAI가 GPT-5.6 계열 모델(Sol, Terra, Luna)의 출시를 미국 정부 요청에 따라 ‘신뢰할 수 있는 소수 파트너’로 제한했습니다. 단순한 모델 출시 소식이 아니라 정부가 고객 단위로 접근을 통제하는 선례가 생겼다는 점이 중요해서, 한국의 AI 기업과 개발자에게도 모델 접근성·배포 규제 리스크를 다시 보게 만드는 뉴스입니다.
TechCrunch
Liquid AI's smallest model yet LFM2.5-230M beats models 4X its size at data extraction, can run 'anywhere'
Liquid AI가 2억3000만 파라미터 규모의 LFM2.5-230M을 공개했는데, 데이터 추출 벤치마크에서 자신보다 4배 큰 모델들보다 낫다고 주장합니다. 32K 컨텍스트, 400MB 미만 메모리 사용량, 온디바이스 실행을 내세우며 스마트폰·노트북·로보틱스 같은 엣지 환경을 정조준했습니다. 한국에선 온디바이스 AI, 로봇, 경량 에이전트 제품을 만드는 팀이라면 클라우드 비용 없이 어디까지 성능을 낼 수 있는지 가늠해볼 만한 사례입니다.
VentureBeat
Nvidia just showed that the harness, not the AI model, is now the real hero
Nvidia가 공개한 연구는 장기 추론·행동 과제에서 핵심은 모델보다도 메모리 관리, 도구 사용, 감독자 역할을 포함한 ‘하네스’ 설계라는 점을 보여줍니다. 맞춤형 하네스를 붙인 Claude Opus 5가 ARC-AGI-3에서 100%를 기록했고, 하네스 없이 같은 모델은 30%에 그쳤다는 점은 한국의 AI 서비스·에이전트 개발팀에도 꽤 실무적인 시사점을 줍니다.
TechCrunch
The OlmoEarth Platform: Geospatial inference at planetary scale
Ai2가 OlmoEarth Platform을 공개하며, 약 10TB 규모의 멀티모달 위성 데이터로 사전학습한 Earth observation 모델을 대륙 단위 추론까지 연결하는 인프라를 설명했습니다. 하루 정도에 대륙 규모 영역을 처리하고 제곱킬로미터당 ‘센트의 일부’ 수준 비용으로 운영할 수 있다고 밝혀, 한국의 AI·공공·기후테크 팀에게 대규모 지리공간 추론 시스템 설계 힌트를 줍니다.
Hugging Face Blog
Advancing the price-performance frontier with GPT-5.6
OpenAI가 GPT-5.6 라인업 가격과 성능을 조정했습니다. GPT-5.6 Luna는 80% 인하, Terra는 20% 인하됐고, Sol은 API의 Fast mode로 최대 2.5배 빠른 처리 속도를 제공해 에이전트·코딩 자동화·대규모 워크로드의 비용 구조를 다시 바꿀 가능성이 큽니다.
OpenAI Blog
구글, 개인용 AI 에이전트 '제미나이 스파크' 국내 정식 출시
구글이 개인용 AI 에이전트 ‘제미나이 스파크’를 한국에 정식 출시했다는 소식입니다. 단순 모델 발표가 아니라 실제 사용자 워크플로를 바꿀 수 있는 AI 제품 출시라는 점에서 의미가 크고, 국내 AI 서비스 경쟁과 온디바이스·에이전트 UX 흐름을 보는 데도 중요합니다.
AITimes
DeepSeek-V4-Flash 모델 공개
DeepSeek가 DeepSeek-V4-Flash API를 퍼블릭 베타로 공개했습니다. 기존 호출 방식은 유지하면서 모델명만 `deepseek-v4-flash`로 바꾸면 되고, Terminal Bench 2.1 82.7, DSBench-FullStack 68.7 등 코딩·에이전트 벤치마크가 V4-Pro-Preview보다 크게 높아졌다고 주장합니다. 한국 개발팀 입장에선 Codex/Responses API 호환성과 에이전트 성능 개선이 실제 개발 자동화 스택 교체 후보가 될 수 있다는 점이 포인트입니다.
GeekNews