Boston Children’s, AI로 새로운 진단 가능성 연다
보스턴 어린이병원이 내부 ChatGPT 기반 ‘엔터프라이즈 AI 레이어’를 구축해 희귀질환 40건 이상을 새로 진단하고, 6만 시간의 업무 시간을 절감했으며, 700만 달러 이상의 인력을 재배치했다고 소개한 사례입니다. 단발성 툴 도입이 아니라 연구·진료·행정을 아우르는 공통 AI 인프라와 거버넌스를 만든 점이 핵심입니다. 다만 OpenAI 고객 사례 형식이라 수치와 효과를 해석할 때는 마케팅 성격을 감안할 필요가 있습니다.
OpenAI Blog
2000달러로 만든 AI 영화, 트라이베카서 첫 공개
제작비 2,000달러 수준의 AI 생성 장편 영화 ‘Dreams of Violets’가 트라이베카 영화제에서 상영됩니다. Google Nano Banana, Kling AI, Claude 등을 활용해 75분 분량을 만들었다는 점에서, 한국의 콘텐츠·미디어 업계에도 ‘저비용 AI 제작 파이프라인’이 어디까지 올라왔는지 보여주는 사례입니다.
The Verge
Grok keeps sending gibberish responses to users
xAI의 Grok이 일부 사용자에게 PDF 생성 요청 후 의미 없는 횡설수설 응답을 내보내는 이상 현상을 보이고 있습니다. 최첨단 모델 경쟁 못지않게 운영 안정성과 출력 품질 관리가 중요하다는 점을 보여주는 사례라, AI 기능을 제품에 붙이는 국내 팀에도 참고할 만합니다.
TechCrunch
The Best Google Home Speaker (2026)
Google이 새로운 Google Home Speaker를 내놓고, 기존 Google Assistant를 ‘Google Gemini for Home’으로 대체하는 흐름을 정리한 가이드입니다. 최신 스피커는 Gemini 중심으로 설계됐고, 일부 고급 기능은 구독이 필요하지만 기본 사용은 무료예요. 한국 독자에겐 스마트홈 디바이스 경쟁이 이제 음질보다도 AI 비서 경험과 구독 모델로 옮겨가고 있다는 점이 포인트입니다.
Wired
Fine-tuning forgets. RAG leaks context. Hypernetworks build the model your agent needs on demand.
이 글은 파인튜닝의 catastrophic forgetting과 RAG의 context rot를 짚으며, 작업 시점에 필요한 모델을 동적으로 구성하는 hypernetwork 접근을 대안으로 제시합니다. 에이전트가 긴 업무를 자율적으로 수행하지 못하는 이유를 ‘오케스트레이션’이 아니라 지식이 모델에 들어가는 방식의 문제로 해석한 점은 흥미롭지만, 국내 실무팀이 바로 도입할 수준의 검증된 제품·코드보다는 방향성 제안에 가깝습니다.
VentureBeat
Show HN: 내가 모델 가중치 안에 있는지 확인하기
`IN THE WEIGHTS`는 이름을 입력해 GPT-5.5, Opus 4.8, Grok 4.20, Gemini 3.1 Lite, Llama 3.3 70B 등 13개 모델 안에 자신이 얼마나 ‘기억’돼 있는지 확인해보는 웹사이트입니다. 정식 벤치마크라기보다는 모델 암기·프라이버시 이슈를 직관적으로 보여주는 데모에 가깝지만, 생성형 AI의 데이터 잔존성과 개인정보 감수성을 다시 생각하게 만듭니다. 한국 AI 서비스팀에게도 학습 데이터 처리와 평가 방식에 대한 문제의식을 던지는 사례입니다.
GeekNews
미드저니, AI 이미지 생성 넘어 의료기기 도전…'수중 전신 스캐너' 공개
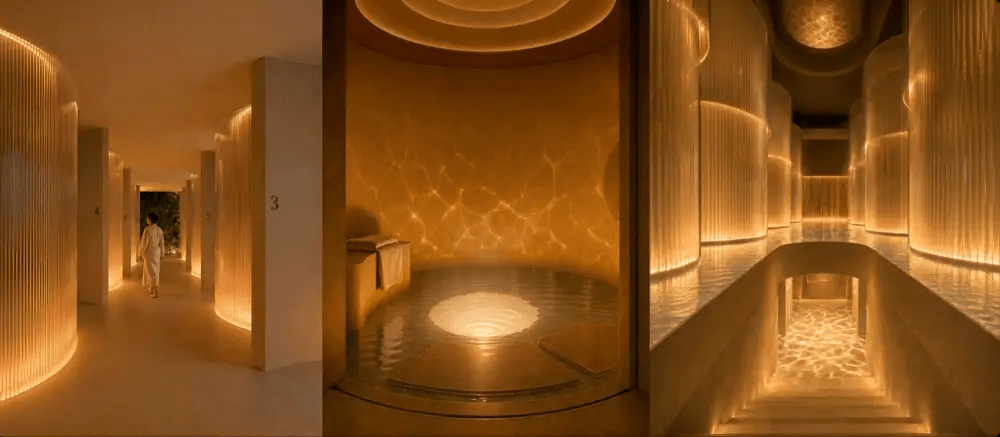
Midjourney가 AI 이미지 생성 서비스를 넘어 초음파 기반 ‘수중 전신 스캐너’를 공개하며 의료기기 분야 진출을 시사했습니다. 다만 아직은 콘셉트와 초기 공개에 가까워 보여, 한국 헬스테크 업계 입장에서는 실제 규제 승인과 임상 검증 단계까지 지켜볼 필요가 있습니다.
AITimes
데이터 제공 대가로 '무료 가사 노동' 제공…뉴욕 '시프트' 프로젝트 논란
뉴욕의 한 AI 스타트업이 무료 청소·요리 서비스를 제공하는 대신 집안 활동 데이터를 수집해 가사 로봇 학습에 활용하는 ‘Shift’ 프로젝트로 논란을 사고 있습니다. 데이터 확보가 로봇 AI 경쟁력의 핵심이라는 점은 분명하지만, 한국에서도 홈 AI·로봇 서비스가 늘어나는 만큼 프라이버시와 보상 설계가 더 민감한 이슈가 될 수 있습니다.
AITimes
깡통 AI들 때문에 두 번째 뇌를 만들게 됐다
작성자는 Claude가 존재하지 않는 옵션과 문법을 답하는 경험을 한 뒤, 배운 내용을 Obsidian에 직접 정리하는 ‘두 번째 뇌’ 방식을 선택했습니다. AI 답변을 그대로 신뢰하기보다 개인 문서화 체계를 만들어 재사용성과 정확도를 높이자는 메시지로, AI를 업무에 쓰는 한국 개발자에게 꽤 현실적인 팁입니다.
GeekNews
Please Stop Making Me Opt Out of AI
Meta가 Instagram 공개 계정을 AI 이미지 생성에 기본 연동했다가 사흘 만에 철회한 사례를 중심으로, Big Tech의 ‘AI 기본 켜짐’ 전략을 비판하는 내용입니다. 한국 서비스 기획자와 PM에게는 생성형 AI 기능을 붙일 때 옵트인/옵트아웃 설계, 프라이버시 고지, 기본값 정책이 얼마나 민감한지 보여주는 사례예요.
Wired
Zero trust must now move at agent speed
Ping Identity CEO는 AI 에이전트가 인간보다 훨씬 빠르게 행동하기 때문에, 로그인 시점이 아니라 각 행동 시점마다 권한을 검증하는 제로트러스트가 필수라고 주장합니다. 한국 기업에도 각 에이전트별 고유 ID, 최소 권한, 짧은 세션 같은 원칙이 중요하다는 메시지는 유효하지만, 기사 자체는 스폰서 콘텐츠 성격이 강합니다.
VentureBeat
Podcasting platform Riverside enters the newsletter publishing game
Riverside가 영상·팟캐스트를 AI로 뉴스레터로 바꿔 바로 발송할 수 있는 기능을 추가했습니다. Mailchimp나 Substack을 정면으로 겨냥했다기보다, 크리에이터가 기존 콘텐츠를 재활용해 배포 채널을 넓히는 워크플로우 자동화 도구라는 점에서 미디어·마케팅 팀에 실용적입니다.
TechCrunch
SpaceX Showed Investors Prototype of Elon Musk’s New AI Device
SpaceX가 투자자들에게 xAI 기술을 통합한 새로운 핸드셋형 AI 디바이스 프로토타입을 보여줬다는 보도다. 아직 제품 세부 정보는 부족하지만, AI를 전용 하드웨어로 묶으려는 시도라는 점에서 한국의 모바일·디바이스 업계에도 흥미로운 신호다.
WSJ Tech
Librarians are hosting viral ‘Avoiding AI’ workshops for people who are fed up with Big Tech
미국 도서관에서 Apple Intelligence와 Gemini를 끄는 방법을 알려주는 ‘Avoiding AI’ 워크숍이 인기를 끌고 있다는 내용입니다. 생성형 AI 확산이 곧바로 사용자 수용으로 이어지지 않는다는 점을 보여주며, 한국 서비스 기획자와 플랫폼 기업에도 ‘AI 기본 탑재’보다 선택권·프라이버시 설계가 중요하다는 메시지를 던집니다.
TechCrunch
AI companies destroy physical books – let's scan rare books before it's too late
Anna’s Archive는 일부 AI 기업들이 희귀 서적을 대량 구매해 스캔한 뒤 폐기하면서, 인간 지식이 비공개 모델 학습 데이터로만 잠길 수 있다고 경고합니다. 검증이 더 필요한 주장도 섞여 있지만, 한국 AI 업계와 출판·아카이빙 분야엔 데이터 확보 경쟁이 저작권을 넘어 물리적 문화유산 보존 문제로 확장되고 있다는 점이 중요한 메시지입니다.
Hacker News Best
의존성에 LLM 생성 코드 금지
git-annex 유지관리자는 최근 한 달간 약 100시간을 들여 의존성 트리에서 LLM 생성 코드를 제거했다고 밝혔습니다. 대규모 AI 생성 커밋의 품질 저하, 저작권 위험, 리뷰 비용 증가를 구체적 사례와 함께 지적한 글로, 생성형 AI가 오픈소스 공급망에 어떤 부담을 주는지 보여줍니다. 한국 개발팀도 AI 코드 사용 정책과 서드파티 의존성 검증 기준을 다시 점검하게 만드는 문제 제기입니다.
GeekNews
메타, 바이브 코딩 기반 앱·게임 소셜 플랫폼 '포켓' 출시
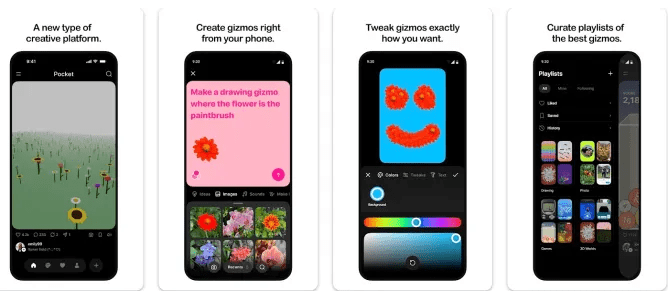
메타가 바이브 코딩을 기반으로 앱·게임을 만들고 공유하는 소셜 플랫폼 ‘포켓’을 출시했다는 기사입니다. 생성형 AI를 단순 보조도구가 아니라 창작·배포 플랫폼으로 확장하려는 시도라서, 국내에서도 AI 기반 UGC 서비스와 게임 제작 툴 시장에 어떤 영향을 줄지 지켜볼 만합니다.
AITimes
오픈AI 부사장 "단일 벤치마크 한계...'테스트 타임 컴퓨트'로 바꿔야"
오픈AI 부사장이 단일 벤치마크 중심 평가의 한계를 지적하며, 모델 성능을 볼 때 '테스트 타임 컴퓨트' 같은 새로운 기준이 필요하다고 주장했습니다. 한국 AI 실무자에게는 모델 비교를 단순 점수표가 아니라 추론 비용·시간·확장성까지 함께 봐야 한다는 메시지로 읽힙니다.
AITimes
Run AI workloads on any cloud, store on Hugging Face: zero-egress storage with SkyPilot
Hugging Face와 SkyPilot가 어떤 클라우드에서든 AI 워크로드를 돌리면서 저장소는 Hugging Face 쪽에 두는 zero-egress 스토리지 방식을 소개한 글로 보입니다. 전문이 없어 세부 구현은 확인되지 않지만, 데이터 이동 비용과 클라우드 종속성을 줄이는 방향이라는 점은 분명합니다. 한국 팀에도 멀티클라우드 GPU 운용과 데이터 비용 최적화 관점에서 눈여겨볼 만한 주제입니다.
Hugging Face Blog
GLM 5.2와 다가오는 AI 추론 마진 붕괴
이 글은 GLM 5.2를 GPT·Claude급 오픈웨이트 경쟁자로 평가하면서, 앞으로 AI 시장의 진짜 변수는 학습비보다 추론 마진 붕괴라고 주장합니다. 한국 AI 업계에도 중요한 포인트는 모델 성능 경쟁이 곧 API 가격 경쟁과 수익성 압박으로 이어질 수 있다는 점입니다.
GeekNews
Who’s Afraid of Chinese Models?
이 글은 중국 AI 모델의 부상을 과도한 위협으로만 볼 필요는 없지만, 미국은 개방형 대안을 더 적극적으로 키워야 한다고 주장합니다. 한국 테크 업계에는 모델 성능 경쟁만이 아니라 오픈 생태계·정책·배포 전략이 AI 주도권의 핵심 변수라는 점을 다시 상기시킵니다.
Stratechery
합성 소비자, 실전 활용 가능성을 입증하다
Bain은 기업 내부의 거래·행동·인구통계·고객 피드백 데이터를 바탕으로 만든 ‘합성 소비자’가 이제 제품 개발, 마케팅 테스트, 현장 인력 훈련 같은 실전 영역에서 반복 가능한 분석 도구로 쓰이고 있다고 설명합니다. 한국 기업 입장에선 고객 데이터 자산을 AI 시뮬레이션 자산으로 전환해, 설문과 FGI 중심의 의사결정을 얼마나 자동화할 수 있을지가 핵심 포인트입니다.
GeekNews
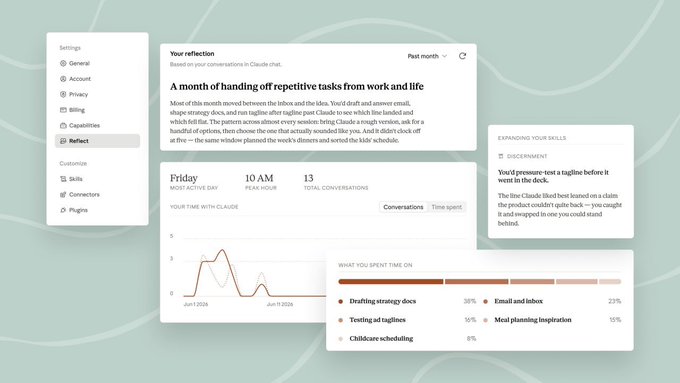
"내 클로드 사용 습관 분석한다"…앤트로픽, '리플렉트' 기능 베타 출시
앤트로픽이 Claude 사용 습관을 분석해주는 베타 기능 ‘리플렉트’를 내놨다는 소식입니다. 프롬프트 작성이나 업무 패턴을 되돌아보는 기능이라면 팀 단위 AI 활용 최적화에 도움이 될 수 있어, 생성형 AI를 실무에 붙이고 있는 국내 조직에도 관심 포인트가 있습니다.
AITimes
Harvard’s $699 startup bootcamp offers AI avatars of its instructors
Harvard Business School이 699달러짜리 8주 창업 부트캠프에 HeyGen 기반 AI 아바타를 도입해, 피치 연습과 이사회 시뮬레이션 피드백을 제공하고 있습니다. 한국 에듀테크·기업교육 업계에도 강사 확장성과 개인화 피드백 자동화라는 현실적인 AI 활용 모델을 보여주는 사례입니다.
TechCrunch
우리는 어떻게 걱정을 멈추고 캠퍼스 감시를 사랑하게 되었나
MIT가 수백 대의 감시 카메라와 Ambient.ai 기능 도입을 검토하면서, 교수진 사이에서 사생활 침해와 동의 없는 시험 적용에 대한 비판이 커지고 있습니다. 한국의 대학·공공기관·기업도 AI 보안 시스템을 도입하는 흐름이 있는 만큼, 기술 자체보다 거버넌스와 구성원 동의가 핵심 리스크라는 점을 잘 보여줍니다.
GeekNews
HBO Max embraces vertical video with a new ‘Shorts’ feed
HBO Max가 TikTok식 세로형 'Shorts' 피드와 함께 AI 기반 대화형 검색 실험을 시작합니다. 방대한 콘텐츠 라이브러리에서 무엇을 볼지 찾기 어려운 문제를, 숏폼 탐색과 자연어 검색으로 해결하려는 시도입니다. 한국 OTT와 미디어 플랫폼에도 추천·검색 UX가 생성형 AI와 숏폼 소비 습관에 맞춰 빠르게 재편되고 있다는 점이 중요합니다.
TechCrunch
AI에 관하여
저자는 초기 회의론에서 벗어나 Claude Code와 로컬 모델을 실제 개발 워크플로에 받아들이게 된 과정을 공유합니다. 과장된 AI 담론과는 거리를 두면서도, 코드베이스 이해·파일 수정·오프라인 로컬 실행 같은 실제 효용을 짚어 한국 개발자에게 ‘어디까지 실용적인가’를 생각하게 합니다.
GeekNews
Perplexity employee who worked on Comet launches an AI browser aimed at knowledge work
Perplexity의 Comet 작업에 참여했던 인력이 지식 노동에 특화된 AI 브라우저를 새로 선보였습니다. 2025년 AI 브라우저 붐 이후 OpenAI Atlas 종료, The Browser Company의 방향 전환 같은 재편이 이어지는 가운데 나온 시도라서, 한국 개발자·프로덕트팀에겐 브라우저가 단순 탐색 도구에서 업무 인터페이스로 바뀌는 흐름을 보여줍니다.
TechCrunch
프론티어 AI가 반도체 산업을 닮아가는 이유
이 글은 GPT-4 학습비용 수천만~1억 달러+, 3nm 칩 설계·제조 비용 수억~수백억 달러 규모를 나란히 놓고, 프론티어 AI가 반도체처럼 ‘계속 달려야 하는 자본집약 산업’이 되고 있다고 분석합니다. 한국 독자에겐 SK hynix·삼성전자 같은 반도체 생태계와 AI 인프라 경쟁을 함께 보는 관점을 준다는 점에서 의미가 있습니다.
GeekNews
I Got a Free Meal From a Private Chef—Who Filmed It All to Train Robots
독일 스타트업 Microagi 산하 Shift가 무료 청소·요리 서비스를 제공하는 대신, 작업자의 1인칭 시점 손동작 데이터를 촬영해 로봇 학습용 데이터로 수집하고 있다는 내용입니다. 휴머노이드·가정용 로봇이 실제 집안일을 배우기 위해 어떤 데이터 파이프라인이 필요한지 보여줘서, 로보틱스·AI 업계에 있는 한국 독자들에게도 꽤 시사점이 있습니다.
Wired