Codex로 자기개선형 세무 에이전트 구축하기
OpenAI와 Thrive Holdings는 회계법인 네트워크 Crete를 위해 세무 업무용 Tax AI를 만들었고, 이 시스템이 운영 중 수집한 신호를 바탕으로 스스로 성능을 개선한다고 설명했습니다. 파일럿 기간 동안 7,000건의 세금 신고를 처리했고, 정확도는 최대 97%, 세무 준비 시간은 약 3분의 1 절감, 처리량은 약 50% 증가했다고 합니다. 한국에서도 회계·법무·백오피스 업무에 AI 에이전트를 붙이려는 팀이라면 ‘배포 후 자동 개선’ 구조를 참고할 만합니다.
OpenAI Blog
Gemini Spark는 OpenClaw의 24시간 AI 에이전트에 대한 Google의 대응
구글이 Gemini Spark를 통해 이메일, 일정, 영수증, 회의록 등을 계속 살피고 사용자가 자리를 비운 동안에도 작업을 수행하는 24/7형 AI 에이전트를 선보였습니다. 초기에는 월 100달러 이상 요금제 사용자에게 베타로 제공되지만, 한국 SaaS·업무자동화 시장에는 ‘앱을 여는 AI’가 아니라 ‘항상 돌아가는 AI’ 경쟁이 본격화된다는 신호입니다.
Wired
"매일 아침 나를 위한 스토리 생성"... 구글, AI 브리핑 '드림빈즈' 공개
구글이 사용자의 서비스 데이터를 바탕으로 매일 맞춤형 콘텐츠를 생성해주는 AI 실험 앱 ‘드림빈즈(Dreambeans)’를 공개했습니다. ‘Personal Intelligence’와 최신 AI 기술을 결합해 개인화된 브리핑·스토리 경험을 제공하려는 시도로, 검색 이후의 차세대 소비자 인터페이스를 시험하는 모습입니다. 한국 서비스 기획자와 AI PM에게는 개인 데이터 활용, 추천 UX, 멀티서비스 연동이 앞으로 AI 제품 경쟁력의 핵심이 된다는 신호입니다.
AITimes
Chinese AI Startup DFSX Releases Chip to Take on the West
중국 AI 스타트업 DFSX가 서방 제재를 우회하기 위해 전부 자국 공급망으로 만든 자체 AI 칩을 공개했습니다. 성능 자체보다도 ‘국산화된 AI 반도체 스택’이라는 점이 핵심이라, 한국 반도체 업계엔 중국의 자립 속도와 시장 분화 가능성을 보여주는 뉴스입니다.
WSJ Tech
Mark Zuckerberg, Meta의 새 AI 에이전트로 기업 운영 전반 맡기려 한다
메타가 새로운 AI 에이전트를 통해 단순 챗봇을 넘어서 기업 업무 전반을 대신 수행하는 방향으로 확장하려 하고 있습니다. 광고 중심 소비자 사업을 넘어 B2B AI 플랫폼으로 수익원을 넓히려는 시도로, 한국 기업 입장에선 향후 업무 자동화 도입 시 메타까지 주요 벤더 후보군에 들어올 수 있다는 신호입니다.
WSJ Tech
Gemini의 새 AI 에이전트, Google 데모 수준과 큰 차이 없다
The Verge가 직접 써본 Gemini Spark는 이메일 작성, 스프레드시트 탐색, 다단계 작업 수행 등에서 데모 수준에 꽤 근접한 성능을 보여줬습니다. 다만 비용과 프라이버시 부담이 여전히 크다는 평가로, 한국 실무자 입장에서는 ‘AI 에이전트가 어디까지 실사용 가능한가’를 가늠해볼 만한 사례입니다.
The Verge
3B 모델로 '제미나이 3 프로' 수학 실력 능가..웨이보, 벤치마크 논쟁 촉발
시나 웨이보 연구진이 공개한 30억 파라미터 모델 'VibeThinker-3B'가 수학 영역에서 Gemini 3 Pro급 성능을 냈다고 주장하며 벤치마크 논쟁이 커지고 있습니다. 사실이라면 훨씬 작은 모델로 고성능을 내는 효율 경쟁이 본격화된다는 뜻이라, 한국 기업들에도 경량 모델·온디바이스 AI 전략의 중요성을 다시 부각시키는 뉴스입니다.
AITimes
MS, 코딩·에이전트 기능 통합한 '코파일럿 슈퍼 앱' 개발 중
마이크로소프트가 코딩 지원, 업무 협업, AI 에이전트 기능을 하나로 통합하는 ‘코파일럿 슈퍼 앱’을 개발 중인 것으로 전해졌습니다. 개발자 도구와 업무 자동화가 단일 AI 인터페이스로 수렴하는 흐름을 보여주는 사례라서, 국내 기업의 Copilot·에이전트 도입 전략에도 적지 않은 영향을 줄 수 있습니다.
AITimes
구글, ‘나노 바나나 2·프로’ 정식 출시…"동영상 보고 이미지 만든다"
구글이 기업용 AI 플랫폼에서 이미지 생성 모델 ‘나노 바나나 2’와 ‘나노 바나나 프로’를 정식 출시했습니다. 특히 영상까지 입력으로 받아 이미지를 만드는 멀티모달 기능을 추가해, 광고·커머스·콘텐츠 자동화 수요가 큰 한국 기업들에게 생성형 미디어 경쟁이 더 빨라졌다는 점을 보여줍니다.
AITimes
Pokémon Go 이용자들, 군사용 드론 기술 개발에 자신도 모르게 기여
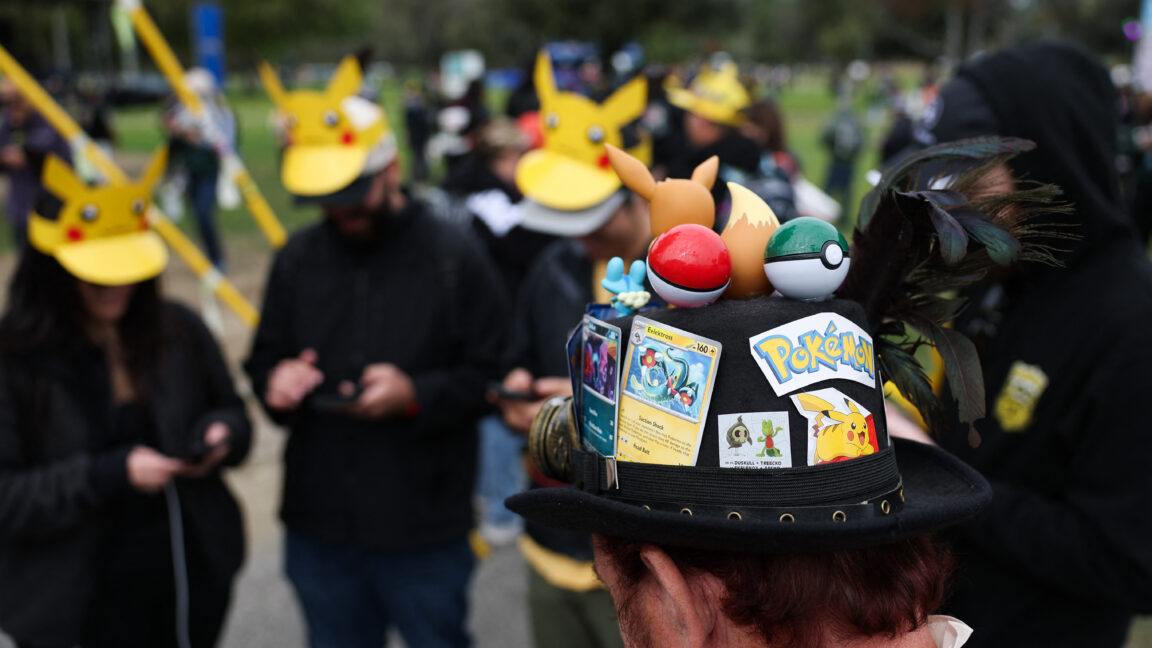
포켓몬 고와 Scaniverse 이용자들이 촬영한 수십억 장의 이미지가 Niantic Spatial의 ‘대규모 지리공간 모델’ 학습에 쓰였고, 이 기술이 배달 로봇은 물론 군사용 드론 항법에도 활용될 가능성이 제기됐습니다. 현실 세계 데이터를 모으는 소비자 앱이 결국 로보틱스·국방 AI의 기반 자산이 될 수 있다는 점에서, 한국의 지도·모빌리티·AR 기업에도 데이터 거버넌스와 이용자 동의 문제가 더 중요해질 수 있습니다.
Ars Technica
아티피셜 애널리시스, ‘딥SWE’ 벤치마크 도입...'페이블 5' 코딩 1위 등극
아티피셜 애널리시스가 코딩 에이전트 평가 기준을 SWE-bench Pro에서 새 벤치마크 ‘DeepSWE’로 바꾸면서 모델 순위가 재편됐고, 클로드 페이블 5가 1위로 올라섰습니다. 한국 개발팀에는 ‘어떤 모델이 최고인가’보다 ‘무슨 벤치마크로 평가했는가’가 더 중요해졌다는 점을 보여주는 사례입니다.
AITimes
Kimi K2.7-Code, 사고 토큰 30% 절감… 현업선 벤치마크 신뢰성 의문 제기
Moonshot AI가 오픈소스 코딩 모델 Kimi K2.7-Code를 내놓으며 추론 토큰 사용량 30% 절감과 성능 향상을 주장했지만, 실무자들은 공개 벤치마크에서 체감이 다르다고 지적합니다. OpenAI 호환 API, Hugging Face 가중치, vLLM/SGLang 배포 지원은 매력적이지만, 한국 팀이 프로덕션에 넣기 전엔 독립 평가를 꼭 확인해야 한다는 기사입니다.
VentureBeat
프런티어 LLM들, 현실 세계 팩트체크에서 의견 엇갈려
이 글은 여러 프론티어 LLM이 실제 사실 검증 과제에서 얼마나 자주 서로 다른 답을 내놓는지 분석합니다. 모델 간 불일치 자체가 평가 신호가 될 수 있다는 점을 보여줘, 한국 기업들이 RAG·리서치 에이전트·검증 파이프라인을 설계할 때 단일 모델 의존을 줄이고 합의 기반 검증을 고민하게 만드는 내용입니다.
Hacker News Best
클로드, 단백질 설계·분석 화학서 성능 입증…"화학자급 직관까지 구현"
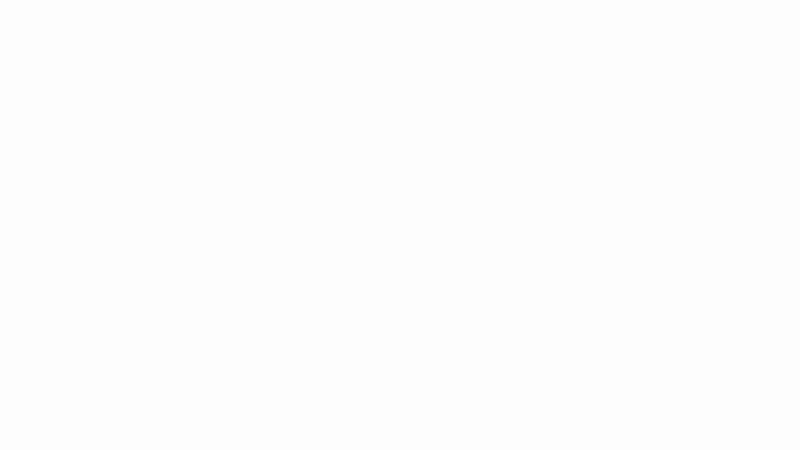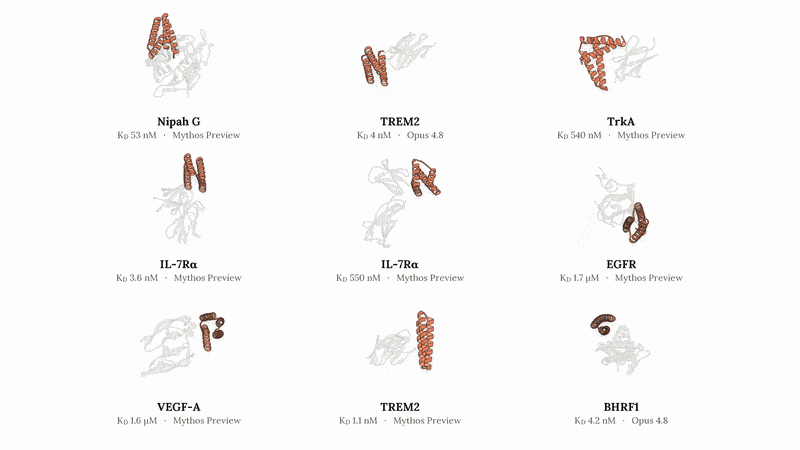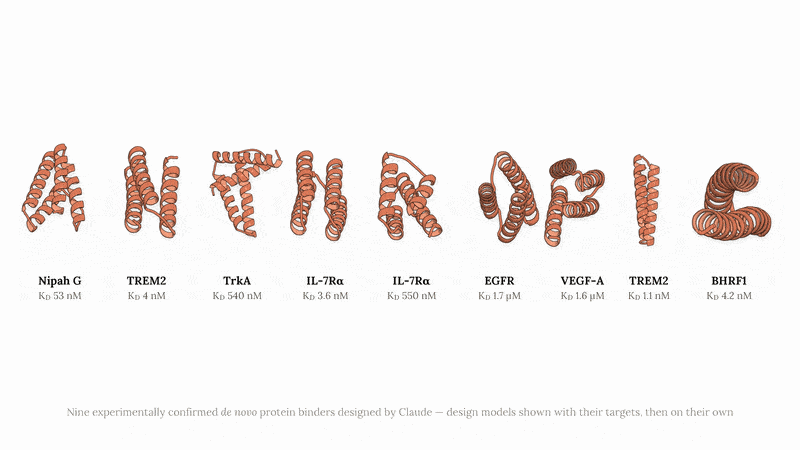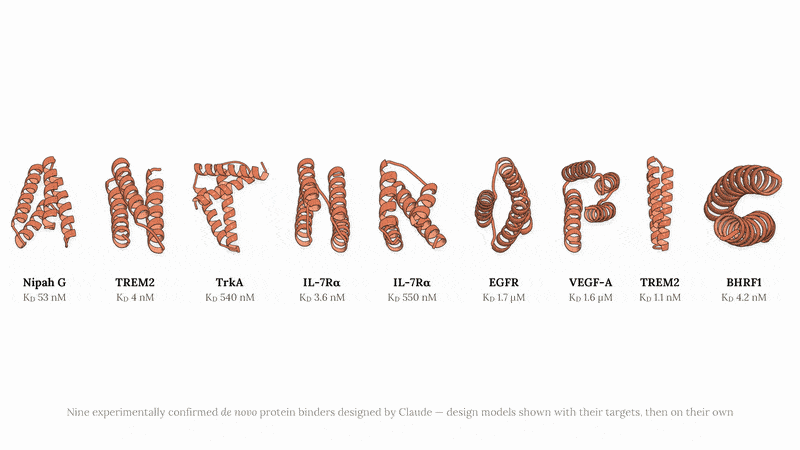
Claude가 단백질 설계와 분석 화학 분야에서 높은 성능을 보였고, 기사에 따르면 화학자 수준의 직관에 가까운 능력까지 시사했습니다. 바이오·신약·소재 AI에 관심 있는 한국 연구자와 스타트업에는, 범용 LLM이 과학 도메인 업무까지 파고들고 있다는 점이 핵심 포인트입니다.
AITimes
AI Isn’t Smarter Than a Baby—Yet
Meta·Stanford·도쿄대 등 연구진이 아기 시점 영상 1,000시간으로 VLM을 평가하는 ‘EgoBabyVLM’ 챌린지를 만들었고, 최신 모델들이 이 과제에서 크게 고전했다고 합니다. 핵심은 지금의 AI가 방대한 데이터와 전력을 써도 아기처럼 적은 경험으로 세상을 배우지 못한다는 점이에요. 한국 AI 연구자와 로보틱스 팀엔 데이터 효율, 멀티모달 학습, embodied AI 방향성을 다시 생각하게 하는 신호입니다.
Wired
백악관, 민·관 AI 사이버 보안 동맹 '골든 이글' 출범...오픈소스도 합류
미 백악관이 민관 협력 AI 사이버 보안 동맹 ‘골든 이글’을 출범시키고 오픈소스 진영까지 참여시켰습니다. AI 보안이 국가 차원의 핵심 의제로 격상됐다는 신호라서, 한국 기업과 보안팀도 향후 공급망 보안·모델 보안 기준 변화에 대비할 필요가 있습니다.
AITimes
Ultrasound imaging turns a robot hand into a skillful mimic
MIT와 USC 연구진이 손목에 붙이는 초음파 밴드와 AI 모델을 결합해 손가락 5개와 손바닥의 움직임을 실시간으로 추적하고, 이를 무선으로 로봇 손에 그대로 복제하는 데 성공했습니다. 피아노 연주나 미니 농구 슈팅 같은 데모까지 보여줬고, 앞으로는 더 작은 하드웨어와 대규모 손동작 데이터셋으로 휴머노이드 학습까지 노리고 있어요. 한국의 로봇·XR 업계엔 정밀한 인간-로봇 인터페이스의 새로운 센서 스택 후보라는 점에서 의미가 큽니다.
MIT Technology Review
Apple Intelligence approved for launch in China with Alibaba and Baidu
중국 당국이 Apple Intelligence의 현지 출시를 승인했고, Apple은 iOS·iPadOS·macOS·visionOS에 Alibaba의 Qwen 모델을 통합해 서비스를 제공할 예정입니다. Apple의 생성형 AI가 중국 시장에 본격 진입한다는 의미라서, 한국 업계엔 온디바이스 AI 경쟁뿐 아니라 중국 현지화·규제 대응 전략이 얼마나 중요한지 보여주는 사례입니다.
TechCrunch
Agility, Maker of Humanlike Robots, to Go Public in $2.5 Billion SPAC Deal
휴머노이드 로봇 기업 Agility가 기업가치 25억 달러 규모의 SPAC 합병으로 상장을 추진합니다. 자사 로봇 Digit은 이미 Amazon 등 제조·물류 현장에서 사용되고 있어, 휴머노이드가 데모를 넘어 실제 운영 단계로 이동하고 있다는 점이 핵심입니다. 한국 제조·물류·로봇 업계에는 현장 자동화의 다음 단계가 생각보다 빨리 올 수 있다는 신호입니다.
WSJ Tech
오픈소스 이미지 모델 '크레아 2' 출시... "2초 만에 기업용 이미지 생성"
오픈소스 이미지 생성 모델 ‘크레아 2’가 출시됐고, 기업용 이미지를 약 2초 만에 생성할 수 있다고 합니다. 속도와 오픈소스라는 조합은 국내 스타트업·마케팅·커머스 팀이 자체 워크플로에 붙여보기 좋다는 점에서 실용성이 큽니다.
AITimes
The AI context gap: Enterprise AI organizations have a trust problem, not a retrieval problem — and most are still building the fix
101개 기업 중 57%가 최근 6개월 내 AI 에이전트가 빠지거나 불일치한 비즈니스 컨텍스트 때문에 자신감 있게 틀린 답을 내놓는 문제를 겪었습니다. OpenAI File Search와 Vertex AI Search 같은 provider-native 도구가 벡터DB보다 빠르게 채택되는 흐름도 보여줘, 한국 개발팀엔 RAG 자체보다 semantic layer와 데이터 거버넌스가 더 중요하다는 시사점을 줍니다.
VentureBeat
Claude Meets Blackwell Ultra: Anthropic’s Models Now Run on NVIDIA GB300 in Azure
Anthropic의 Claude 모델이 Microsoft Foundry에서 NVIDIA GB300 Blackwell Ultra GPU 기반으로 Azure에 정식 제공됩니다. 기업은 NVL72 시스템과 Secure Agent Workspace 참조 설계를 활용해 더 강력한 에이전트형 AI를 구축할 수 있어, 한국 기업 입장에서도 멀티벤더 AI 인프라 전략과 비용 최적화 흐름을 읽는 데 의미가 있습니다.
Nvidia Blog
100달러 AI 뮤직비디오 제작 대결: Claude Fable 5 vs. GPT-5.6 Sol
이 글은 Claude Fable 5와 GPT-5.6 Sol에 동일한 노래와 예산($25, $100)을 주고, 영상 생성·편집을 자율적으로 수행하게 한 비교 실험입니다. 각 모델의 툴 호출, 실패 횟수, 생성 비용, 출력 해상도까지 공개했고, 실험용 하네스도 오픈소스로 배포했습니다. 한국 AI 실무자에겐 ‘에이전트가 긴 작업을 예산 안에서 어떻게 계획하고 실행하는지’를 구체적으로 볼 수 있는 좋은 사례입니다.
GeekNews
The Pentagon wants $30 million to build an AI-powered lie detector
미 국방부가 향후 5년간 3,030만 달러를 들여 AI·머신러닝 기반 거짓말 탐지 프로그램 ‘Polygraph+’를 추진하려 합니다. 비접촉 생체신호 측정과 자동 채점 알고리즘으로 정확도를 높이겠다는 계획이지만, 전문가들은 기존 폴리그래프 자체의 한계 위에 AI를 얹는 ‘최악의 조합’이 될 수 있다고 지적합니다. 한국 테크 업계엔 AI가 공공·안보 영역에서 어떻게 도입되고, 동시에 신뢰성·윤리성 검증이 얼마나 중요한지 보여주는 사례입니다.
MIT Technology Review
Fable을 이기는 ‘짧은 목줄’ AI 코딩 방법
Okturtles는 보안이 중요한 소프트웨어에서 AI 코딩 에이전트에 자율 실행을 맡기기보다, 개발자가 변경을 계속 통제하는 ‘Short Leash’ 방식을 권장합니다. 병렬 에이전트가 알아서 코드를 만드는 vibe식 접근의 한계를 짚으면서, 사람 중심 검토 흐름을 강조해 한국 기업의 안전한 AI 코딩 도입에 시사점을 줍니다.
GeekNews
Kimi Work: 지식 노동자를 위한 차세대 데스크톱 AI 에이전트
Kimi Work는 내장 Cron 엔진을 통해 브리핑 작성, 데이터 처리 같은 반복 업무를 상시 자동화하는 데스크톱 AI 에이전트로 소개됐습니다. 한국의 지식노동자와 운영팀 입장에선 ‘챗봇’이 아니라 백그라운드에서 일하는 에이전트형 UX가 어디까지 실무를 대체할지 가늠해볼 만한 신호입니다.
GeekNews
Anthropic brings Claude Cowork to mobile and web as usage data shows most users aren’t coding
Anthropic가 Claude Cowork를 모바일과 웹으로 확장했고, 60만 개 이상 조직의 120만 세션 분석 결과 코딩보다 운영·문서·콘텐츠 업무 비중이 훨씬 높다고 밝혔습니다. AI 보조도구의 주 전장이 개발자에서 일반 지식노동으로 옮겨가고 있다는 신호라, 국내 SaaS·협업툴·업무자동화 시장에도 직접적인 시사점이 있습니다.
VentureBeat
텐센트, 'Hy3' 오픈소스 정식 출시…'GLM-5.2' 절반 크기로 코딩 외 성능 압도
텐센트가 오픈소스 모델 'Hy3'를 정식 출시했는데, 기사에 따르면 GLM-5.2의 절반 크기이면서 코딩 외 여러 성능에서 우위를 주장합니다. 경량화와 성능을 함께 잡는 중국 오픈모델 경쟁이 더 치열해졌다는 뜻이라, 국내 AI 개발자에게도 비용 대비 성능 좋은 대안 모델을 점검할 필요가 커졌습니다.
AITimes
ChatGPT can now send texts for you with new Apple Messages plug-in
OpenAI가 ChatGPT용 Apple Messages 플러그인을 출시해, 사용자가 메시지함을 연결하면 대화 정리·분석·편집은 물론 텍스트 전송까지 ChatGPT에서 처리할 수 있게 됐습니다. Codex와 ChatGPT Work에서도 동작해 개인용을 넘어 업무용 자동화까지 확장되는 만큼, AI가 메신저·업무 툴 안으로 더 깊게 들어오는 흐름을 보여줍니다.
TechCrunch
57% of enterprises have watched AI agents be confidently wrong. The fix is an agentic context layer, but who has one?
설문에 따르면 57%의 기업이 AI 에이전트가 확신에 차서 틀린 답을 한 원인을 ‘비즈니스 컨텍스트 부족 또는 불일치’로 추적했고, 75%는 아직 agentic context layer를 갖추지 못했습니다. RAG만으로는 부족하다는 문제의식을 보여주는 자료라서, 한국 기업의 데이터 카탈로그·시맨틱 레이어·MCP 연동 전략에도 직접적인 영향을 줄 만한 내용입니다.
VentureBeat